Un estudi va examinar 36.487 repositoris de programari i va confirmar bucles autònoms d’agents d’IA en 217. Més interessant que el percentatge és el que sabem —i el que encara ignorem— sobre els controls i els resultats d’aquests sistemes.
Al juny va començar a circular una expressió nova: loop engineering. La idea sonava irresistible. En lloc d’estar pendent de Claude Code, Codex o qualsevol altre agent, muntes un sistema que li encarrega tasques una darrere l’altra. Tu et dediques a una altra cosa i l’agent continua treballant. En qüestió de setmanes van aparèixer fils, diagrames i receptes sobre com fer-ho. Gairebé tots parlaven de productivitat. Força menys explicaven com mesurar-la.
A mi l’assumpte em toca de prop. Fa mesos que construeixo UXMachine amb agents d’IA i he après que deixar-los avançar té els seus riscos. En una ocasió, un d’ells es va posar a fer comprovacions que ningú li havia demanat fins a omplir el disc. No era exactament un d’aquests bucles autònoms programats, però el problema s’hi assemblava molt: podia continuar fent coses sense que estigués clar quan s’havia d’aturar.
Per això m’interessa més la pregunta que ve després d’automatitzar: com sabem que tantes execucions ens han servit realment d’alguna cosa?
Què és, exactament, el loop engineering
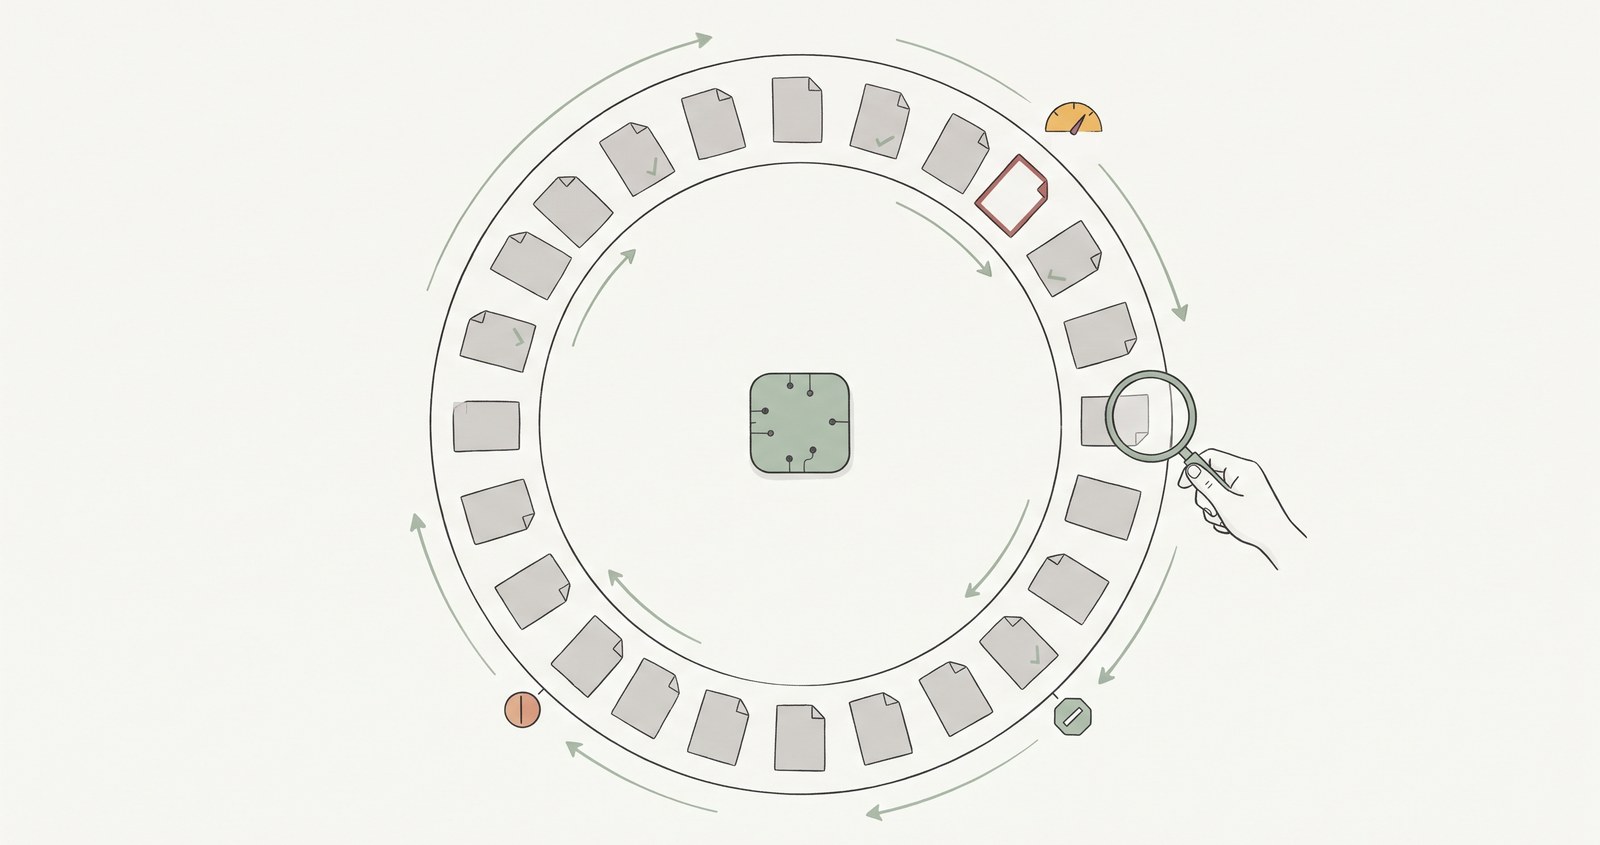
Un agent de programació ja funciona mitjançant petits cicles: consulta fitxers, executa eines, observa els resultats i decideix què fer a continuació. El loop engineering hi afegeix una altra capa. En comptes d’iniciar tu cada sessió, prepares un mecanisme perquè les sessions arrenquin per un horari o per un esdeveniment: arriba una incidència, falla una prova, algú obre una proposta de canvi.
En la seva versió més acurada, el sistema també hauria de saber quin objectiu persegueix, com comprovar el resultat, quant pot gastar i quan s’ha d’aturar o demanar ajuda. Però una cosa és aquesta definició i una altra el que trobem en els projectes reals.
El que van trobar en 36.487 repositoris
A l’agost, investigadors de la Universitat de Heidelberg i de la Singapore Management University van decidir examinar el fenomen. El seu treball, Loop Engineering: Building Blocks, Adoption, and Impact, es va actualitzar el 22 d’octubre. El 5 de novembre, Ichigo el va recuperar en un fil d’X que em va portar a llegir-lo amb més deteniment.
Van partir de 36.710 repositoris de programari de codi obert. Després d’eliminar duplicats i projectes que ja no eren accessibles, en van quedar 36.487. Les seves cerques van localitzar 256 casos possibles i, després d’examinar les configuracions i els registres disponibles, van confirmar que 217 havien executat bucles autònoms d’agents. Un 0,59 % de la mostra.
Convé no confondre aquesta xifra amb el percentatge de desenvolupadors que fan servir agents d’aquesta manera. L’estudi només podia trobar determinades petjades públiques a GitHub. No veia el que algú executa al seu ordinador, ni configuracions privades ni la part del funcionament que queda fora del repositori.
El que més em va cridar l’atenció va ser la distància entre engegar un agent i controlar el que fa. En la classificació dels 256 candidats inspeccionats, feta amb l’ajuda de Claude Code i revisada per un dels investigadors, van aparèixer aquests mecanismes:
- 101 tenien algun límit de despesa o de torns.
- 76 comptaven amb algun tipus de verificador.
- 55 incloïen un objectiu o una condició d’aturada.
- 35 conservaven estat entre execucions.
- Només 10 registraven el cost.
Aquestes xifres no volen dir que els altres no tinguessin necessàriament aquests controls. Volen dir que els investigadors els van poder identificar en el material examinat. De fet, les cerques directes de fitxers versionats gairebé no van trobar rastres de la memòria i dels altres mecanismes que recomanen les guies sobre loop engineering.
Hi ha una altra dada que rebaixa una mica la imatge de l’agent treballant tota la nit en un gran projecte. Dels 217 casos confirmats, 180 s’activaven principalment per esdeveniments al repositori, sobretot per revisar propostes de canvis. Uns altres 21 funcionaven per horari i 15 combinaven totes dues coses. Una automatització de revisió pot ser útil, és clar. Però no és el mateix que delegar durant hores una tasca complexa i esperar que el sistema trobi tot sol el camí.
I hi ha l’exemple d’un sistema per classificar incidències: havia acumulat 6.290 execucions. En els registres que van comprovar els autors, cap no va arribar a engegar el pas de l’agent, perquè no es van trobar incidències per processar. El flux s’executava; això no volia dir que l’agent hagués treballat.
El que l’estudi no demostra
Aquí hi ha la part que més trobo a faltar en moltes converses sobre IA: distingir entre el que sembla que funciona i el que s’ha demostrat.
El treball de Lulla i els seus col·legues no demostra que el loop engineering augmenti la productivitat. Tampoc no demostra que la redueixi. El que diu és que, en la literatura i els casos que van revisar, falten proves sistemàtiques per sostenir les afirmacions sobre els seus beneficis. Els autors plantegen precisament un experiment posterior per mesurar resultats, qualitat del codi, esforç i consum de recursos.
És un estudi exploratori, no un cens de tots els bucles que existeixen. Les seves heurístiques podien deixar casos fora i bona part de l’estat d’execució no es publica a GitHub. Per això seria excessiu concloure que gairebé ningú no aplica controls. El que sí que mostra l’estudi és una cosa més precisa: és molt més fàcil trobar la configuració que arrenca un agent que les evidències públiques de com se supervisa, què recorda i quant costa.
Hi ha tres bucles diferents, i no convé barrejar-los
El fil d’Ichigo proposa una distinció que em sembla especialment útil:
- El bucle de l’agent. Dins d’una sessió, el model crida eines, n’interpreta les respostes i continua. És el funcionament habitual dels agents actuals.
- El bucle de treball. L’agent lliura alguna cosa, un mecanisme extern la comprova, retorna informació sobre els errors i permet un altre intent. Aquí no n’hi ha prou que l’agent digui «acabat».
- El bucle del sistema. Quan detectes un problema recurrent, canvies les regles, els controls o la manera de treballar perquè el següent intent parteixi de millors condicions. Ja no corregeixes només un resultat: millores el procés que el produeix.
La major part dels casos que va trobar l’estudi corresponen a automatitzacions que engeguen sessions d’agents. Això pot estalviar feina. Però no equival, per si sol, a tenir aquests tres nivells funcionant.
Els dos últims són, per a mi, els interessants. També els que exigeixen més feina humana del que suggereixen molts vídeos d’agents programant sols.
Què guanyem deixant un agent hores treballant sol?
No tinc una resposta universal. Hi ha tasques repetitives i ben delimitades per a les quals l’autonomia té tot el sentit. I n’hi ha d’altres en què acumular intents pot voler dir acumular errors, costos o canvis que després algú haurà de revisar.
Si només comptem execucions, ens perdrem bona part de la història. Caldria comptar també quins canvis han estat útils, quants intents s’han descartat, què ha costat comprovar-los i quant temps humà es necessita per entendre i acceptar el resultat.
La meva experiència amb UXMachine m’ha portat a desconfiar una mica de la paraula «acabat». Que un agent digui que ha completat una tasca no vol dir que estigui ben feta. I que l’hagi feta mentre jo no mirava no hi afegeix cap garantia.
Potser hem començat per la part fàcil: aprendre a arrencar agents i aconseguir que no s’aturin. La part difícil ve després. Saber què han fet, poder-ho comprovar i decidir quan n’hi ha prou.
D’això tractarà el següent article d’aquesta sèrie: La feina de debò comença quan l’agent diu «he acabat».
Font principal: Jai Lal Lulla, Vahram Nersesyan, Seyedmoein Mohsenimofidi, Christoph Treude i Sebastian Baltes, «Loop Engineering: Building Blocks, Adoption, and Impact», arXiv:2608.21884, versió 3 (22 d’octubre de 2026). Preprint presentat a JAWs@ASE 2026.
Escrit amb l’ajuda d’assistents d’IA. La interpretació de l’estudi, els exemples i la decisió de publicar són meus.