El teu agent no recorda que ahir es va equivocar. Si vols que no torni a passar, qui ha de canviar és el sistema en què treballa. Com convertir un error repetit en un canvi que es quedi, i per què escriure-ho en un fitxer no sempre n’hi ha prou.
Hi ha una sensació que coneix qualsevol que treballi amb agents d’IA. Li corregeixes un error, et dona les gràcies, l’arregla. L’endemà, en una altra sessió, torna a cometre exactament el mateix. I tu li tornes a explicar, amb una mica menys de paciència que la primera vegada.
No és mala fe ni falta d’intel·ligència. És que no se’n recorda. Cada conversa comença gairebé de zero, i el que tu vas aprendre ahir no ho va aprendre ell. Si vols que l’error no torni, la memòria ha de ser fora de l’agent: en el sistema en què treballa.
A UXMachine ho vaig aprendre a principis de setembre. L’única comprovació obligatòria abans d’ajuntar un canvi era que el codi estigués ben escrit, sense errors de sintaxi. El 2 de setembre, les proves van fallar a les deu branques en què treballaven els agents aquell dia, i no va bloquejar res, perquè ningú no havia dit que fallar les proves impedís ajuntar. Es van canviar dues coses. Ara un canvi només entra amb totes les proves en verd, comprovades sobre la versió real. I cada control ha de demostrar, amb un error fet expressament, que de debò es posa en vermell quan toca.
El tercer bucle
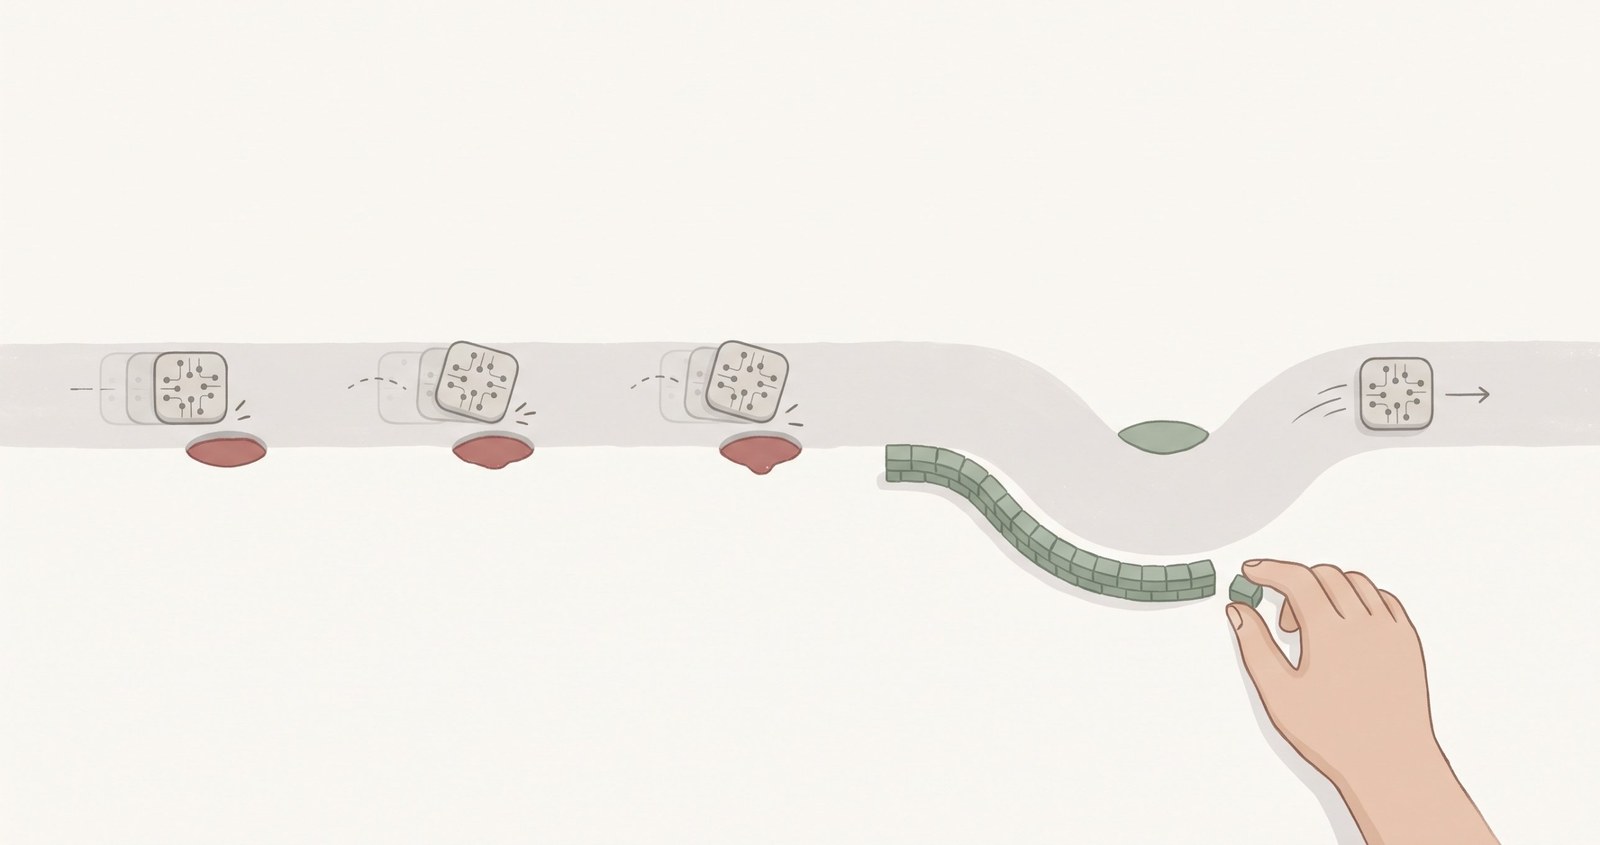
En aquesta sèrie separo tres bucles. El de l’agent, que dura segons: crida una eina, llegeix el que li torna i continua. El de treball, del qual vaig parlar a l’article anterior: algú de fora comprova el resultat i l’hi torna si falla. I el del sistema, que dura dies o setmanes: quan un error es repeteix, es converteix en un canvi permanent.
Una manera senzilla de veure-ho: el bucle de treball és corregir l’examen; el bucle del sistema és canviar com es prepara el següent. El primer arregla el que l’agent acaba de fer. El segon arregla el que fa que s’equivoqui. És l’únic dels tres que aconsegueix que la setmana vinent sigui més barata que aquesta.
La idea de Hashimoto: que no torni a passar
Mitchell Hashimoto ha posat nom a aquest costum: harness engineering, que podríem traduir com l’enginyeria de l’arnès. Cada vegada que un agent comet un error, dediques una estona a dissenyar una solució perquè no el torni a cometre mai més.
Explica dues maneres de fer-ho:
- Escriure-ho. Afegeix una línia al fitxer d’instruccions que l’agent llegeix en començar cada sessió, l’AGENTS.md. En un dels seus, diu, cada línia surt d’un mal comportament de l’agent, i gairebé tots van desaparèixer.
- Donar-li una eina. Per exemple, un petit programa que fa captures de pantalla o que passa només les proves que importen. I després l’anota a l’AGENTS.md perquè l’agent sàpiga que existeix.
Una regla escrita és un desig
Aquí convé no ser massa optimista. Escriure una línia en un fitxer d’instruccions és el més fàcil, i no sempre el més eficaç.
Un estudi publicat al febrer, Evaluating AGENTS.md, ho va mesurar amb diversos agents i models. Els fitxers d’instruccions, en general, no van augmentar les tasques resoltes, i van encarir cada tasca més d’un 20 % de mitjana. Els agents sí que seguien les instruccions; el que no ajudava eren les descripcions generals del projecte. La conclusió dels autors és prudent: aquests fitxers serveixen per deixar per escrit el que el teu projecte fa diferent del que és habitual, i tota la resta convé mesurar-la abans de donar-la per bona.
Ichigo ho resumeix amb una imatge que m’agrada molt. «No toquis les migracions», escrit en un fitxer de text, és un desig: l’agent ho llegirà i gairebé sempre ho complirà. Una regla que li treu el permís de tocar-les és un mur: ho complirà encara que se li oblidi. Per això proposa aquest ordre quan alguna cosa falla:
- Primer, l’estructura: que l’error no es pugui cometre.
- Després, una comprovació automàtica que el detecti sempre.
- Text a les instruccions, només on de debò cal criteri.
- I una persona que revisa, al final.
La raó és gairebé comptable. Una línia a les instruccions es paga a cada sessió, i l’agent la pot passar per alt. Una comprovació automàtica, un cop feta, no costa res.
Arreglar-ho on es produeix, no on es veu
Hi ha un error d’enfocament molt habitual: arreglar l’error just on s’ha vist. A la Guia AI-First ho vaig escriure així: si una cosa torna després d’arreglar-la, és que es va arreglar on es va observar, no on es produeix. I «un error arreglat on es va observar està amagat, no arreglat».
La guia proposa una pregunta senzilla abans de donar una cosa per tancada: si això mateix aparegués en un altre lloc, ho aturaria alguna cosa? Si la resposta és no, encara no està acabat.
I hi ha un contrapès que també és a la guia: un control que mai no s’ha posat en vermell, o no està provat, o sobra. Per això cada comprovació nova hauria de demostrar, almenys una vegada, que detecta l’error per al qual existeix.
Dels prompts a una manera de treballar
Al principi pensava que el truc era demanar millor. Ara crec que és decidir abans.
A la guia, cada encàrrec diu «què es fa, què no es toca, com es comprova i quan s’atura». I abans de començar, una línia: «què hauria de passar perquè ho deixés?». La resta en surt:
- Què pot tocar. No li demanis a l’agent que no toqui una cosa: treu-li el permís. «El que un rol pot tocar no se li diu, se li limita.»
- Qui decideix què. Per a cada paper, dues columnes: què decideix i què no decideix. La segona és la difícil, i l’única que serveix quan hi ha pressa.
- Quan s’atura. Una condició d’aturada escrita abans de començar. Un termini no és una condició d’aturada.
- Qui ho mira abans que surti. El lliurament s’accepta sobre el resultat real, no sobre el que l’agent diu que ha fet. I si no ho pots mirar tu, algú ho ha de fer, i no pot ser l’agent.
Saber què abasta cada agent
Per posar un mur, primer cal saber on fa falta. Amb diversos agents al mateix ordinador això no és evident: cadascun llegeix els seus fitxers, les seves eines i les seves claus, i de vegades els dels altres.
Per això faig RosmarOps. Llegeix la configuració dels agents que hi ha al teu ordinador i dibuixa un mapa del que cadascun pot abastar. No canvia els teus agents ni posa límits: t’ensenya on són avui, perquè decideixis tu on van els murs.
Tres preguntes per a la propera vegada que un agent repeteixi un error
- On es produeix l’error, i no només on l’he vist?
- Puc fer que no es pugui cometre, o que una comprovació el detecti sempre, abans d’escriure-ho a les instruccions?
- Si apareix en un altre lloc, ho aturaria alguna cosa?
El que no s’arregla amb regles
Un sistema que aprèn evita repetir errors. Però hi ha un cost que no apareix en cap error: construir més de pressa del que entens. D’això tracta l’últim article de la sèrie.
Fonts: Mitchell Hashimoto, «My AI Adoption Journey» (5 de febrer de 2026); Gloaguen, Mündler-Sasahara, Müller, Raychev i Vechev, «Evaluating AGENTS.md: Are Repository-Level Context Files Helpful for Coding Agents?», arXiv:2602.11988 (12 de febrer de 2026); Albert Garcia Pujadas, Guia AI-First (en castellà); fil d’Ichigo a X (5 de novembre de 2026).
Escrit amb l’ajuda d’assistents d’IA. Els exemples, la interpretació i la decisió de publicar són meus.