Un estudio examinó 36.487 repositorios de software y confirmó bucles autónomos de agentes de IA en 217. Más interesante que el porcentaje es lo que sabemos —y lo que todavía ignoramos— sobre los controles y los resultados de esos sistemas.
En junio empezó a circular una expresión nueva: loop engineering. La idea sonaba irresistible. En lugar de estar pendiente de Claude Code, Codex o cualquier otro agente, montas un sistema que le encarga tareas una detrás de otra. Tú te dedicas a otra cosa y el agente sigue trabajando. En cuestión de semanas aparecieron hilos, diagramas y recetas sobre cómo hacerlo. Casi todos hablaban de productividad. Bastantes menos explicaban cómo medirla.
A mí el asunto me toca de cerca. Llevo meses construyendo UXMachine con agentes de IA y he aprendido que dejarles avanzar tiene sus riesgos. En una ocasión, uno de ellos se puso a hacer comprobaciones que nadie le había pedido hasta llenar el disco. No era exactamente uno de esos bucles autónomos programados, pero el problema se parecía mucho: podía seguir haciendo cosas sin que estuviera claro cuándo debía parar.
Por eso me interesa más la pregunta que viene después de automatizar: ¿cómo sabemos que tantas ejecuciones nos han servido realmente para algo?
Qué es, exactamente, el loop engineering
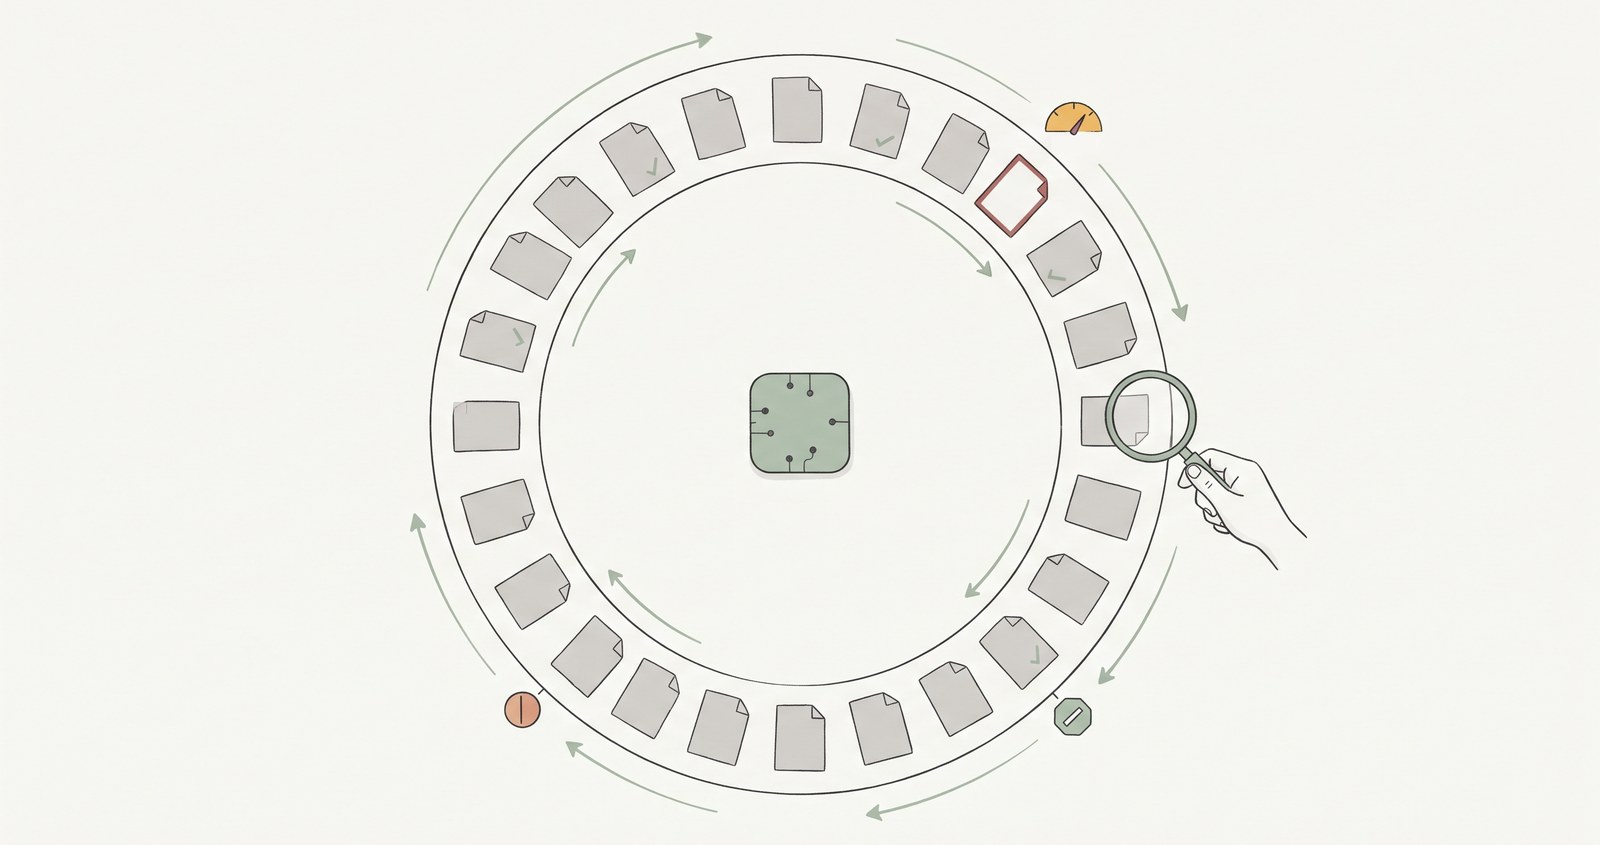
Un agente de programación ya funciona mediante pequeños ciclos: consulta archivos, ejecuta herramientas, observa los resultados y decide qué hacer a continuación. El loop engineering añade otra capa. En vez de iniciar tú cada sesión, preparas un mecanismo para que las sesiones arranquen por un horario o un acontecimiento: llega una incidencia, falla una prueba, alguien abre una propuesta de cambio.
En su versión más cuidada, el sistema también debería saber qué objetivo persigue, cómo comprobar el resultado, cuánto puede gastar y cuándo tiene que detenerse o pedir ayuda. Pero una cosa es esa definición y otra lo que encontramos en los proyectos reales.
Lo que encontraron en 36.487 repositorios
En agosto, investigadores de Heidelberg University y Singapore Management University decidieron examinar el fenómeno. Su trabajo, Loop Engineering: Building Blocks, Adoption, and Impact, fue actualizado el 22 de octubre. El 5 de noviembre, Ichigo lo recuperó en un hilo de X que me llevó a leerlo con más detenimiento.
Partieron de 36.710 repositorios de software de código abierto. Después de eliminar duplicados y proyectos que ya no estaban accesibles, quedaron 36.487. Sus búsquedas localizaron 256 posibles casos y, tras examinar las configuraciones y los registros disponibles, confirmaron que 217 habían ejecutado bucles autónomos de agentes. Un 0,59 % de la muestra.
Conviene no confundir esa cifra con el porcentaje de desarrolladores que usan agentes de esta manera. El estudio solo podía encontrar determinadas huellas públicas en GitHub. No veía lo que alguien ejecuta en su ordenador, ni configuraciones privadas ni parte del funcionamiento que queda fuera del repositorio.
Lo que más me llamó la atención fue la distancia entre poner un agente en marcha y controlar lo que hace. En la clasificación de los 256 candidatos inspeccionados, realizada con ayuda de Claude Code y revisada por uno de los investigadores, aparecieron estos mecanismos:
- 101 tenían algún límite de gasto o de turnos.
- 76 contaban con algún tipo de verificador.
- 55 incluían un objetivo o condición de parada.
- 35 conservaban estado entre ejecuciones.
- Solo 10 registraban el coste.
Estas cifras no significan que los demás carecieran necesariamente de esos controles. Significan que los investigadores pudieron identificarlos en el material examinado. De hecho, las búsquedas directas de archivos versionados apenas encontraron rastros de la memoria y los demás mecanismos que recomiendan las guías sobre loop engineering.
Hay otro dato que rebaja un poco la imagen del agente trabajando toda la noche en un gran proyecto. De los 217 casos confirmados, 180 se activaban principalmente por acontecimientos en el repositorio, sobre todo para revisar propuestas de cambios. Otros 21 funcionaban por horario y 15 combinaban ambas cosas. Una automatización de revisión puede ser útil, desde luego. Pero no es lo mismo que delegar durante horas una tarea compleja y esperar que el sistema encuentre por sí solo el camino.
Y está el ejemplo de un sistema para clasificar incidencias: había acumulado 6.290 ejecuciones. En los registros que comprobaron los autores, ninguna llegó a poner en marcha el paso del agente, porque no se encontraron incidencias que procesar. El flujo se ejecutaba; eso no significaba que el agente hubiera trabajado.
Lo que el estudio no demuestra
Aquí está la parte que más echo de menos en muchas conversaciones sobre IA: distinguir entre lo que parece funcionar y lo que se ha demostrado.
El trabajo de Lulla y sus colegas no demuestra que el loop engineering aumente la productividad. Tampoco demuestra que la reduzca. Lo que dice es que, en la literatura y los casos que revisaron, faltan pruebas sistemáticas para sostener las afirmaciones sobre sus beneficios. Los autores plantean precisamente un experimento posterior para medir resultados, calidad del código, esfuerzo y consumo de recursos.
Es un estudio exploratorio, no un censo de todos los bucles que existen. Sus heurísticas podían dejar casos fuera y buena parte del estado de ejecución no se publica en GitHub. Por eso sería excesivo concluir que casi nadie aplica controles. Lo que sí muestra el estudio es algo más preciso: resulta mucho más fácil encontrar la configuración que arranca un agente que las evidencias públicas de cómo se supervisa, qué recuerda y cuánto cuesta.
Hay tres bucles distintos, y no conviene mezclarlos
El hilo de Ichigo propone una distinción que me parece especialmente útil:
- El bucle del agente. Dentro de una sesión, el modelo llama a herramientas, interpreta sus respuestas y sigue. Es el funcionamiento habitual de los agentes actuales.
- El bucle de trabajo. El agente entrega algo, un mecanismo externo lo comprueba, devuelve información sobre los fallos y permite otro intento. Aquí no basta con que el agente diga «terminado».
- El bucle del sistema. Cuando detectas un problema recurrente, cambias las reglas, los controles o la forma de trabajar para que el siguiente intento parta de mejores condiciones. Ya no corriges solo un resultado: mejoras el proceso que lo produce.
La mayor parte de los casos encontrados por el estudio corresponden a automatizaciones que ponen en marcha sesiones de agentes. Eso puede ahorrar trabajo. Pero no equivale, por sí solo, a tener esos tres niveles funcionando.
Los dos últimos son, para mí, los interesantes. También los que exigen más trabajo humano del que sugieren muchos vídeos de agentes programando solos.
¿Qué ganamos dejando a un agente horas trabajando solo?
No tengo una respuesta universal. Hay tareas repetitivas y bien delimitadas para las que la autonomía tiene todo el sentido. Y hay otras en las que acumular intentos puede significar acumular errores, costes o cambios que luego alguien tendrá que revisar.
Si solo contamos ejecuciones, nos perderemos buena parte de la historia. Habría que contar también qué cambios han sido útiles, cuántos intentos se han descartado, qué ha costado comprobarlos y cuánto tiempo humano se necesita para entender y aceptar el resultado.
Mi experiencia con UXMachine me ha llevado a desconfiar un poco de la palabra «terminado». Que un agente diga que ha completado una tarea no quiere decir que esté bien hecha. Y que la haya hecho mientras yo no miraba no añade ninguna garantía.
Tal vez hemos empezado por la parte fácil: aprender a arrancar agentes y conseguir que no se detengan. La parte difícil viene después. Saber qué han hecho, poder comprobarlo y decidir cuándo es suficiente.
De eso tratará el siguiente artículo de esta serie: El trabajo de verdad empieza cuando el agente dice «he terminado».
Fuente principal: Jai Lal Lulla, Vahram Nersesyan, Seyedmoein Mohsenimofidi, Christoph Treude y Sebastian Baltes, «Loop Engineering: Building Blocks, Adoption, and Impact», arXiv:2608.21884, versión 3 (22 de octubre de 2026). Preprint presentado en JAWs@ASE 2026.
Escrito con ayuda de asistentes de IA. La interpretación del estudio, los ejemplos y la decisión de publicar son míos.