Tu agente no recuerda que ayer se equivocó. Si quieres que no vuelva a pasar, quien tiene que cambiar es el sistema en el que trabaja. Cómo convertir un error repetido en un cambio que se quede, y por qué escribirlo en un fichero no siempre basta.
Hay una sensación que conoce cualquiera que trabaje con agentes de IA. Le corriges un error, te da las gracias, lo arregla. Al día siguiente, en otra sesión, vuelve a cometer exactamente el mismo. Y tú vuelves a explicárselo, con un poco menos de paciencia que la primera vez.
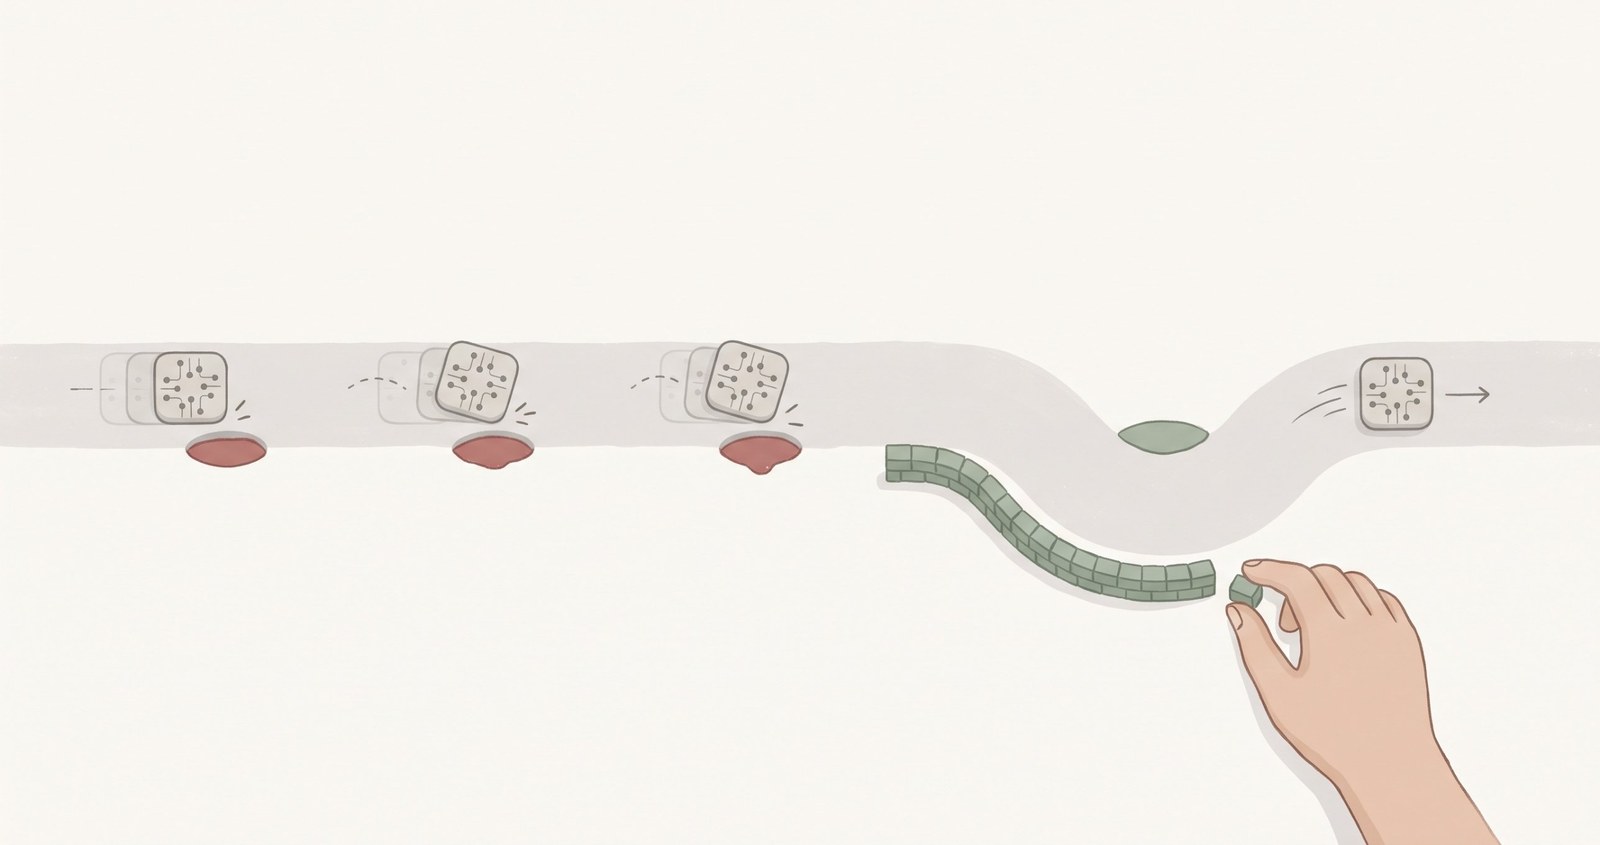
No es mala fe ni falta de inteligencia. Es que no se acuerda. Cada conversación empieza casi de cero, y lo que tú aprendiste ayer no lo aprendió él. Si quieres que el error no vuelva, la memoria tiene que estar fuera del agente: en el sistema en el que trabaja.
En UXMachine aprendí esto a principios de septiembre. La única comprobación obligatoria antes de juntar un cambio era que el código estuviera bien escrito, sin errores de sintaxis. El 2 de septiembre, las pruebas fallaron en las diez ramas en las que trabajaban los agentes ese día, y no bloqueó nada, porque nadie había dicho que fallar las pruebas impidiera juntar. Se cambiaron dos cosas. Ahora un cambio solo entra con todas las pruebas en verde, comprobadas sobre la versión real. Y cada control tiene que demostrar, con un fallo hecho a propósito, que de verdad se pone en rojo cuando debe.
El tercer bucle
En esta serie separo tres bucles. El del agente, que dura segundos: llama a una herramienta, lee lo que le devuelve y sigue. El de trabajo, del que hablé en el artículo anterior: alguien de fuera comprueba el resultado y se lo devuelve si falla. Y el del sistema, que dura días o semanas: cuando un fallo se repite, se convierte en un cambio permanente.
Una forma sencilla de verlo: el bucle de trabajo es corregir el examen; el bucle del sistema es cambiar cómo se prepara el siguiente. El primero arregla lo que el agente acaba de hacer. El segundo arregla lo que hace que se equivoque. Es el único de los tres que consigue que la semana que viene sea más barata que esta.
La idea de Hashimoto: que no vuelva a pasar
Mitchell Hashimoto le ha puesto nombre a esta costumbre: harness engineering, que podríamos traducir como la ingeniería del arnés. Cada vez que un agente comete un error, dedicas un rato a diseñar una solución para que no lo vuelva a cometer nunca.
Cuenta dos maneras de hacerlo:
- Escribirlo. Añade una línea al fichero de instrucciones que el agente lee al empezar cada sesión, el AGENTS.md. En uno de los suyos, dice, cada línea sale de un mal comportamiento del agente, y casi todos desaparecieron.
- Darle una herramienta. Por ejemplo, un pequeño programa que hace capturas de pantalla o que pasa solo las pruebas que importan. Y después lo anota en el AGENTS.md para que el agente sepa que existe.
Una regla escrita es un deseo
Aquí conviene no ser demasiado optimista. Escribir una línea en un fichero de instrucciones es lo más fácil, y no siempre lo más eficaz.
Un estudio publicado en febrero, Evaluating AGENTS.md, lo midió con varios agentes y modelos. Los ficheros de instrucciones, en general, no aumentaron las tareas resueltas, y encarecieron cada tarea más de un 20 % de media. Los agentes sí seguían las instrucciones; lo que no ayudaba eran las descripciones generales del proyecto. La conclusión de los autores es prudente: esos ficheros sirven para dejar por escrito lo que tu proyecto hace distinto de lo habitual, y todo lo demás conviene medirlo antes de darlo por bueno.
Ichigo lo resume con una imagen que me gusta mucho. «No toques las migraciones», escrito en un fichero de texto, es un deseo: el agente lo leerá y casi siempre lo cumplirá. Una regla que le quita el permiso de tocarlas es un muro: lo cumplirá aunque se le olvide. Por eso propone este orden cuando algo falla:
- Primero, la estructura: que el error no se pueda cometer.
- Después, una comprobación automática que lo detecte siempre.
- Texto en las instrucciones, solo donde de verdad hace falta criterio.
- Y una persona que revisa, al final.
La razón es casi contable. Una línea en las instrucciones se paga en cada sesión, y el agente puede pasarla por alto. Una comprobación automática, una vez hecha, no cuesta nada.
Arreglarlo donde se produce, no donde se ve
Hay un error de enfoque muy habitual: arreglar el fallo justo donde se ha visto. En la Guía AI-First lo escribí así: si algo vuelve después de arreglarlo, es que se arregló donde se observó, no donde se produce. Y «un fallo arreglado donde se observó está escondido, no arreglado».
La guía propone una pregunta sencilla antes de dar algo por cerrado: si esto mismo apareciera en otro sitio, ¿lo pararía algo? Si la respuesta es no, todavía no está terminado.
Y hay un contrapeso que también está en la guía: un control que nunca se ha puesto en rojo, o no está probado, o sobra. Por eso cada comprobación nueva debería demostrar, al menos una vez, que detecta el fallo para el que existe.
De los prompts a una forma de trabajar
Al principio pensaba que el truco estaba en pedir mejor. Ahora creo que está en decidir antes.
En la guía, cada encargo dice «qué se hace, qué no se toca, cómo se comprueba y cuándo se para». Y antes de empezar, una línea: «¿qué tendría que pasar para que lo dejara?». Lo demás sale de ahí:
- Qué puede tocar. No le pidas al agente que no toque algo: quítale el permiso. «Lo que un rol puede tocar no se le dice, se le limita.»
- Quién decide qué. Para cada papel, dos columnas: qué decide y qué no decide. La segunda es la difícil, y la única que sirve cuando hay prisa.
- Cuándo para. Una condición de parada escrita antes de empezar. Un plazo no es una condición de parada.
- Quién lo mira antes de que salga. La entrega se acepta sobre el resultado real, no sobre lo que el agente dice que hizo. Y si no lo puedes mirar tú, alguien tiene que hacerlo, y no puede ser el agente.
Saber qué alcanza cada agente
Para poner un muro, primero hay que saber dónde hace falta. Con varios agentes en el mismo ordenador eso no es evidente: cada uno lee sus ficheros, sus herramientas y sus claves, y a veces los de los demás.
Por eso hago RosmarOps. Lee la configuración de los agentes que hay en tu ordenador y dibuja un mapa de lo que cada uno puede alcanzar. No cambia tus agentes ni pone límites: te enseña dónde están hoy, para que decidas tú dónde van los muros.
Tres preguntas para la próxima vez que un agente repita un error
- ¿Dónde se produce el error, y no solo dónde lo he visto?
- ¿Puedo hacer que no se pueda cometer, o que una comprobación lo detecte siempre, antes de escribirlo en las instrucciones?
- Si aparece en otro sitio, ¿lo pararía algo?
Lo que no se arregla con reglas
Un sistema que aprende evita repetir errores. Pero hay un coste que no aparece en ningún error: construir más deprisa de lo que entiendes. De eso trata el último artículo de la serie.
Fuentes: Mitchell Hashimoto, «My AI Adoption Journey» (5 de febrero de 2026); Gloaguen, Mündler-Sasahara, Müller, Raychev y Vechev, «Evaluating AGENTS.md: Are Repository-Level Context Files Helpful for Coding Agents?», arXiv:2602.11988 (12 de febrero de 2026); Albert Garcia Pujadas, Guía AI-First; hilo de Ichigo en X (5 de noviembre de 2026).
Escrito con ayuda de asistentes de IA. Los ejemplos, la interpretación y la decisión de publicar son míos.